 Веб- и разработка ПО
Как Celion создаёт веб-сайт: от первого сообщения до запуска
Celion создаёт сайт не ради украшения, а под бизнес-задачу: проектируем путь клиента, закладываем безопасность с самого...
В статье TechCrunch, датированной 13 ноября 2026 года, говорится, что сбой электронной почты Microsoft перерос в масштабный сбой облачных сервисов, а их работа начала восстанавливаться почти через 18 часов. Глобальный сбой облачных сервисов Microsoft показывает одно: отказ Microsoft 365 или Azure — не чрезвычайное исключение, а операционный риск, которым нужно управлять.
Рекомендация проста: не спешите строить дорогую мультиоблачную архитектуру. Сначала найдите процессы, зависящие от одного провайдера. Затем определите независимый канал связи, храните резервные копии в другой среде и проверьте порядок восстановления на практике.
Сначала казалось, что сбой затрагивает только сервисы в США и других странах Америки, но затем он распространился на остальные регионы. Издание объясняет это каскадным программным сбоем: инженеры столкнулись с трудностями при восстановлении отключившихся серверов, а неполадки с электронной почтой затронули другие части инфраструктуры Microsoft.
На вопрос о причинах сбоя облачных сервисов Microsoft нет одного универсального ответа. Ошибка в обновлении программного обеспечения, неверная маршрутизация сети или неполадка в службе идентификации способны сделать даже внешне исправную систему недоступной для пользователей. Например, сервер приложения может продолжать работать, но если вход через Entra ID недоступен, сотрудники все равно не смогут пользоваться системой.
Дата источника не соответствует текущему календарю. Поэтому перед публикацией исходный материал необходимо перепроверить. Не следует без доказательств связывать с этим событием и другие результаты поиска. Например, новость о закупках в сфере геологии в Казахстане ничего не доказывает ни о Microsoft, ни об устойчивости облачных сервисов, ни о влиянии на бизнес в Узбекистане.
Глобальный сбой Microsoft Azure — это не только недоступный сайт. Если Outlook и Teams используются для связи, Entra ID — для входа в системы, а сайт и API размещены в Azure, одно событие может одновременно остановить работу сотрудников и прием заказов от клиентов.
Нужно учитывать и локальные зависимости. Например, сайт размещен в Azure, заказы через API передаются в 1C или Odoo, а менеджер сообщает клиенту статус через Telegram. Если сайт или API перестанут работать, клиент продолжит писать, но менеджер не сможет проверить остатки и состояние заказа. Так технический сбой превращается в невыполненное обещание или потерянный заказ.
Альтернативный канал тоже может зависеть от той же инфраструктуры. Во время сбоя Telegram способен стать основным средством связи. Но если бот, webhook и база данных также размещены в Azure, резервным каналом он не станет.
Не каждой небольшой компании нужна параллельная копия одной и той же системы в нескольких облаках. Такая архитектура дорога и сложна в управлении. Если ущерб от простоя невелик, разумным решением станут отдельно хранящаяся резервная копия, независимый канал связи и зафиксированный порядок ручной работы.
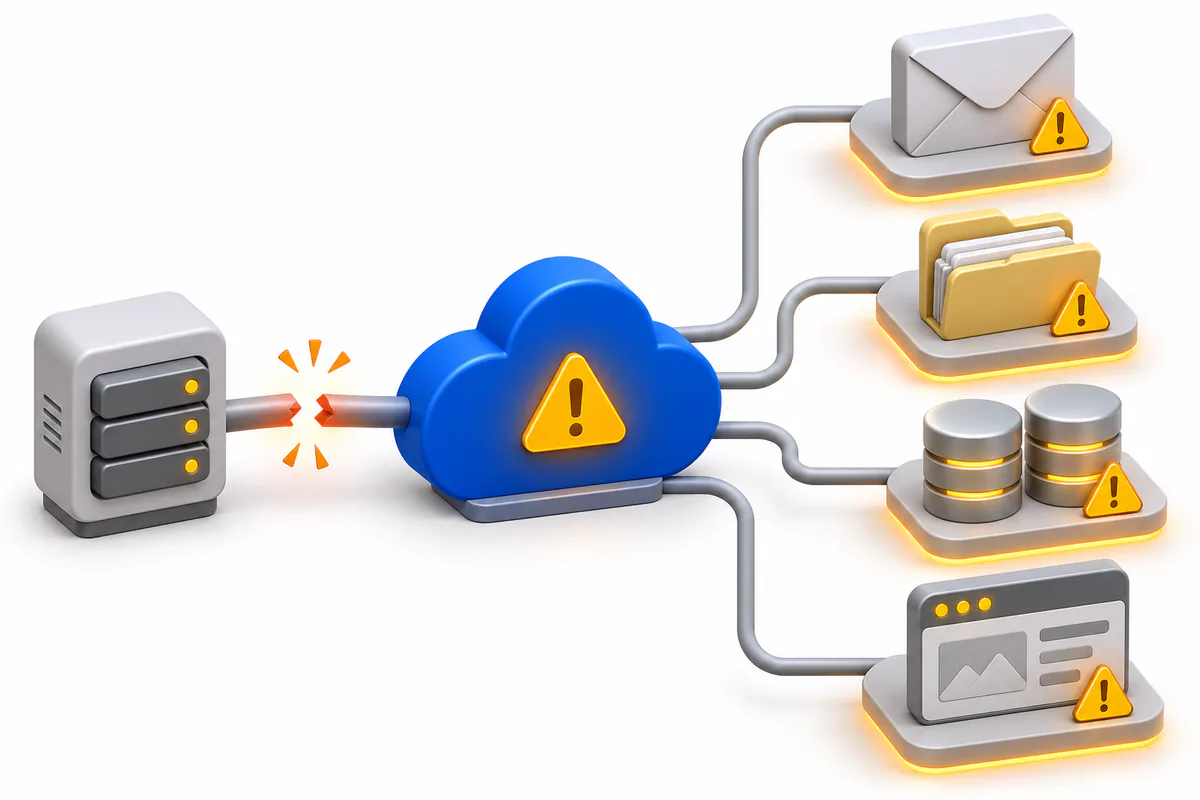
Если облачные сервисы перестали работать, команде не стоит тратить время на догадки о причинах. Технический руководитель фиксирует сбой. Руководитель бизнеса определяет, какие операции остановились. А служба поддержки распространяет только подтвержденную информацию.
Резервный план для облачных систем — это не просто копия файлов. Резервные данные должны храниться за пределами того же tenant или подписки, доступ к ним необходимо защищать отдельно, а восстановление — регулярно тестировать. В плане указывают RPO — какой объем потери данных допустим, и RTO — как долго сервис может оставаться недоступным.
После сбоя восстановите последовательность событий. Запишите, какие предупреждения поступили, какие решения были приняты с опозданием и какие альтернативные пути не сработали. Такой разбор нужен не для поиска виноватых. Его задача — помочь быстрее и безопаснее принимать решения при следующем сбое.
Celion начинает такую работу не со смены провайдера, а с карты зависимостей. Она охватывает веб-уровень — сайт, API и базу данных, а также Microsoft 365, системы идентификации и интеграции с Telegram, 1C или Odoo. Для каждой системы также указывается ответственный. Тогда становится понятно, какие бизнес-процессы остановятся вслед за отказом конкретного сервиса.
Затем выбирается решение, соответствующее уровню риска. Это может быть статическая аварийная страница для клиентов и временная очередь для заказов. Резервные копии хранятся в отдельной среде, уведомления в Telegram и панель мониторинга показывают текущее состояние, а для критически важного API предусматривается альтернативный маршрут. Если потенциальный ущерб от простоя этого не оправдывает, мы не рекомендуем строить дорогую параллельную инфраструктуру.
Правило принятия решения простое. Если отказ системы останавливает продажи или платежи либо не позволяет выполнить данное клиенту обещание, необходимо письменно определить ответственного за систему, альтернативный порядок работы, место хранения резервной копии и порядок тестирования восстановления. Если хотя бы одно из этих полей пустует, план непрерывности бизнеса еще не готов.
С помощью аудита архитектуры веб-систем и разработки интеграций от Celion определите критически важные зависимости, предусмотрите резервные пути и проверьте порядок восстановления на практике.
Обратный звонок
Оставьте Ваши данные и мы свяжемся с Вами в ближайшее время.
Стать партнером
Leave your contact details and we will get back to you shortly.
Order Service
Оставьте Ваш номер телефона и мы свяжемся с Вами в ближайшее время.